Cenários de Automação: do Desenho à Operação Segura
Este guia organiza a visão de “Scenario Automação” para apoiar decisões técnicas, governança e operação contínua em ambientes de automação. Contextualmente, o termo refere-se ao planejamento de fluxos, gatilhos e condições de execução, integrando pessoas, sistemas e regras. Aborda também requisitos e boas práticas para reduzir retrabalho, ampliar rastreabilidade e sustentar a confiabilidade do processo.
1) Visão crítica de “Scenario Automação” para decisões seguras e rastreáveis
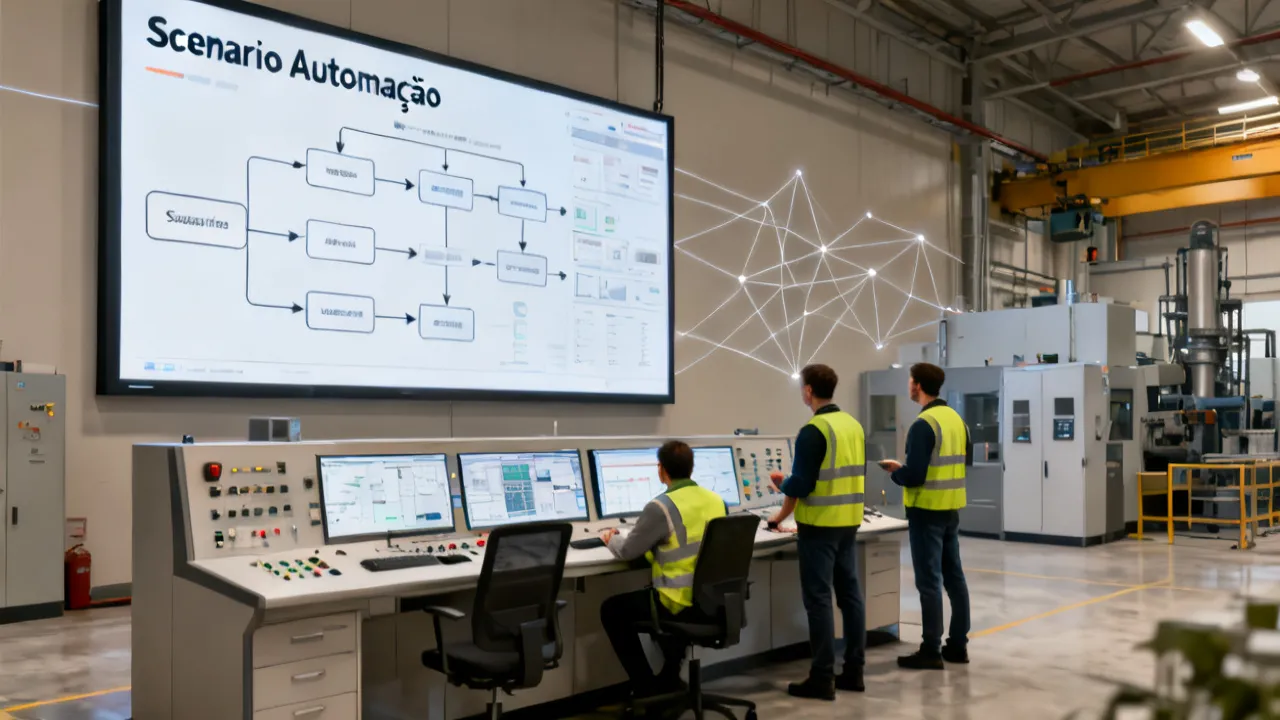
No campo de automação, “Scenario Automação” funciona como um modelo executivo: descreve o que deve acontecer, quando deve acontecer e sob quais condições. Em termos práticos, você transforma intenções (processos de negócio e objetivos operacionais) em fluxos verificáveis (gatilhos, exceções, limites e rotas de continuidade). O ganho principal é a previsibilidade: a operação deixa de depender apenas de “como sempre foi feito” e passa a se apoiar em um desenho que pode ser auditado, testado e melhorado.
Quando bem definido, um cenário reduz ambiguidades entre times (processo, engenharia, TI/OT e operação), melhora o gerenciamento de mudanças e sustenta a confiabilidade ao longo do tempo. Do ponto de vista de um especialista, o valor não está somente em “automatizar”, mas em padronizar decisões automatizadas e criar mecanismos de evidência: logs coerentes, validações de entrada, tratamento de falhas e estratégias de retorno a um estado seguro.
Além disso, a implementação de cenários costuma envolver escolhas de arquitetura (por exemplo, orquestração por eventos, execução em camadas, integração com CLP/SCADA/MES/ERP) e alinhamento de governança. Sem isso, a automação pode até acelerar o ciclo inicial, mas tende a aumentar o custo de manutenção, especialmente em ambientes com múltiplas versões, fornecedores diferentes ou evolução constante de requisitos.
Este artigo oferece uma leitura objetiva e estruturada sobre como desenhar, implementar e operar “Scenario Automação”, tratando também requisitos, condições de validação, e perguntas frequentes, com foco em qualidade industrial e conformidade operacional.
Uma visão crítica, porém, é essencial: cenários podem virar “caixa preta executável” quando não houver critérios de rastreio, quando o modelo for genérico demais ou quando o time confundir “fluxo” com “controle”. Em ambientes regulados ou de alta criticidade, é comum que falhas não ocorram por falta de lógica, mas por falta de contexto: dados incompletos, eventos repetidos, inconsistências entre sistemas e divergências de versão. Por isso, “Scenario Automação” precisa ser tratado como artefato de engenharia, e não apenas como script de automação. Ele deve ser concebido com uma mentalidade de ciclo de vida (design → validação → operação → melhoria → governança).
Na prática, “seguro e rastreável” significa que o cenário consegue responder, com evidência, a perguntas que normalmente surgem sob pressão: “Por que o processo avançou apesar de X?”, “Qual regra foi aplicada no instante T?”, “Qual versão estava ativa?”, “O que aconteceu quando o dado estava fora do padrão?”, “O que mudou desde o último lote bem-sucedido?”. O cenário que não responde a isso cria dependência do operador e aumenta o tempo de diagnóstico, mesmo quando a automação “parece funcionar”.
Outro ponto crítico é o alinhamento entre tempo de decisão e tempo de disponibilidade de dados. Muitas perdas de confiabilidade vêm de atrasos: o cenário decide com base em informação atrasada, ou decide que “não há dado” e segue um caminho não intencional. Assim, a modelagem do cenário precisa prever temporização, janelas de validade (time window), tolerância a latência e políticas para “sem dados”. Isso é especialmente relevante quando existe integração com TI, filas de mensagens, APIs, sincronização de tags e persistência em banco.
Por fim, vale notar que rastreabilidade não é só “logar tudo”. É logar com propósito: registrar eventos relevantes, correlacionar ações com sinais e garantir que cada decisão tenha uma entrada que permita reconstrução. Sem correlação e sem padronização de campos (timestamp, correlação, ID do lote, ID do equipamento, versão do cenário, parâmetros), o log vira ruído e dificulta auditoria. Portanto, um “Scenario Automação” robusto precisa ser definido não só na lógica de controle, mas também na estratégia de observabilidade.
2) O que significa “Scenario Automação” na prática (e por que ele importa)
“Scenario Automação” pode ser entendido como a materialização de um plano operacional em formato executável e verificável. Em vez de uma lista de tarefas, o cenário descreve:
- Entidades e limites: quais equipamentos, sistemas e dados participam do fluxo.
- Gatilhos: eventos que iniciam a automação (ex.: disponibilidade de insumo, leitura de sensor, confirmação de status em sistema).
- Condições: regras que determinam se o passo pode ocorrer (faixas, pré-requisitos, qualidade do dado).
- Sequência e dependências: ordem das ações e dependências entre etapas.
- Tratamento de exceções: o que fazer quando algo falha, fica fora do esperado ou chega atrasado.
- Critérios de sucesso: evidência mínima para considerar o cenário “completo” e “correto”.
Na automação industrial, pequenas inconsistências viram problemas grandes: um sensor com deriva, uma condição mal definida ou um evento duplicado podem causar parada operacional ou produzir registros inconsistentes. Um cenário bem projetado reduz a chance de decisões implícitas “no cérebro do operador” se tornarem variáveis ocultas do sistema.
Isso importa porque a operação não é um único instante de execução; ela é uma sequência de estados sujeita a variabilidade. Materiais chegam com variação de qualidade, equipamentos envelhecem, redes sofrem jitter, e integrações corporativas podem ter janelas de indisponibilidade. Se o cenário não incorpora essa realidade (por meio de critérios de qualidade e exceções), ele tende a falhar “em bordas” (edge cases) — justamente quando o processo mais precisa de confiabilidade.
Outra dimensão do “por que importa” é a governança. Em ambientes onde mudanças são frequentes (novos produtos, ajustes de receita, upgrades de instrumentação), o cenário serve como contrato técnico e operacional: define o que foi implementado e como isso deve se comportar. Assim, quando surge um incidente, você não precisa apenas “achar o problema”, precisa também “provar o que ocorreu” e “justificar a correção”. Sem cenário, a evidência fica espalhada em conversas, tickets e impressões de tela.
O cenário também favorece treinamento. Um operador treinado para reconhecer estados e exceções é mais rápido para reagir do que alguém que apenas conhece procedimentos genéricos. Com estados bem nomeados e com mensagens de erro com contexto, a automação orienta a ação humana com menos improviso.
Além disso, “Scenario Automação” permite evolução incremental. Em vez de reescrever toda a lógica, você pode introduzir melhorias localizadas: ajustar uma regra de validação, ampliar uma tolerância de leitura, criar uma nova rota de recuperação. Isso reduz risco de regressão quando existe uma estratégia de versionamento, testes automatizados e regressão controlada.
Por fim, vale destacar que “executável e verificável” não é apenas “rodar sem erro”. Verificável significa que o cenário pode ser comprovado: por testes (FAT/SAT e testes de integração), por métricas (taxa de exceção, tempos de recuperação, cobertura de estados) e por evidência em logs. Sem essas camadas, o cenário vira uma suposição operacional que pode quebrar em produção.
3) Integração entre processo, tecnologia e operação: o cenário como “ponte”
Um cenário de automação raramente é apenas software. Ele é a ponte entre:
- Processo: objetivo, etapas, políticas e regras de negócio/produção.
- Engenharia de automação: lógicas de controle, comunicação, estados e intertravamentos.
- Camada de TI/integração: eventos, integrações com sistemas corporativos e padronização de dados.
- Operação: monitoramento, atuação, rotinas de contingência e treinamento.
Na prática, isso significa que o desenho do cenário deve ser “traduzível” para todas as frentes. Um diagrama ou documento técnico que não permita rastrear decisões e exceções tende a virar uma referência incompleta para implementação e, mais tarde, para auditoria.
Uma ponte real precisa de “tradução” em dois sentidos: (1) traduzir linguagem de processo para linguagem técnica e (2) traduzir comportamento técnico para linguagem operacional. Por exemplo, “qualidade do lote” pode ser uma regra de negócio (aprovado/reprovado), mas tecnicamente ela se materializa como condições sobre medições e validações. Na operação, isso vira uma orientação: “se o sensor X estiver fora da faixa Y, então o cenário bloqueia e informa a categoria de falha”.
Quando a ponte falha, surgem sintomas comuns: o time de engenharia implementa uma lógica “conservadora” para evitar riscos, mas isso degrada produtividade; o time de operação tenta contornar manualmente; e o time de TI integra dados com atraso ou com semântica diferente (por exemplo, valores equivalentes com escalas diferentes). Sem um cenário bem definido, esses desalinhamentos não ficam claros e, portanto, demoram para serem corrigidos.
Para evitar isso, um bom cenário deve estabelecer:
- Semântica única de estados: o mesmo significado para “Executando”, “Aguardando”, “Bloqueado por qualidade”, “Em recuperação”, etc.
- Contrato de eventos: quais eventos são emitidos, com quais IDs e com quais tempos de validade.
- Política de sincronização: como lidar com leituras que chegam fora de ordem.
- Responsabilidade por cada camada: quem decide o que, e quem apenas executa (e.g., CLP decide intertravamento local; orquestração decide sequenciamento global).
Outro elemento importante é a coesão entre o cenário e o “intertravamento” físico. Em automação de segurança, por exemplo, muitas decisões de alto risco não devem depender de uma camada de software que pode atrasar ou falhar. Nesse caso, o cenário deve respeitar o princípio de que sistemas instrumentados de segurança operam com lógica apropriada e conforme a norma aplicável. O cenário pode orquestrar processos, mas não deve substituir funções de segurança onde isso não for permitido por arquitetura e conformidade.
Além disso, a ponte precisa considerar manutenção: se um dia um sensor for trocado, ou se o método de medição mudar, o cenário deve sobreviver com parametrização e atualização controlada. Quando o cenário é “hard-coded” para uma instrumentação específica, ele tende a quebrar em evolução natural da planta.
Portanto, “Scenario Automação” é ponte porque cria um modelo compartilhado: processo vira regras, tecnologia vira execução, operação vira interação e evidência. Quanto mais clara essa ponte, menor o custo de entendimento e maior a velocidade de resposta a incidentes.
4) Custos, preço e fornecedores: como estruturar a análise sem achismos
Você mencionou “Scenario Automação” junto de informações econômicas e de fornecimento, mas não forneceu valores concretos nem nome de fornecedores nos trechos do briefing. Ainda assim, em termos profissionais, vale adotar um método para avaliação de preço e fornecedores que seja defendível.
Em projetos de automação, “preço” costuma variar conforme:
- Escopo do cenário: número de fluxos, complexidade de exceções e integração com sistemas.
- Infraestrutura existente: disponibilidade de redes, controladores, licenças e instrumentação.
- Ambiente e requisitos de segurança: exigências de intertravamento, validação e comportamento seguro.
- Portabilidade: possibilidade de reutilizar blocos, padronizar bibliotecas e reduzir retrabalho.
- Modelo de entrega: commissioning, testes FAT/SAT, documentação e handover.
O ponto chave do especialista é: não compare apenas “valor total” entre fornecedores. Compare a forma como o cenário será construído, testado e suportado. Isso envolve requisitos documentais, estratégia de versionamento, plano de testes e nível de rastreabilidade. Em cenários complexos, a economia inicial pode desaparecer quando houver falhas de entendimento, retrabalho de integração ou ausência de evidências de validação.
Para tornar a análise menos subjetiva, é recomendável transformar “qualidade de entrega” em critérios mensuráveis. Alguns exemplos práticos de critérios que podem ser incluídos em proposta técnica e que impactam custo ao longo do ciclo de vida:
- Cobertura de testes: quantos caminhos (caminho feliz e falhas) são explicitamente cobertos; quais métricas de cobertura serão usadas (por exemplo, cobertura de estados/transições ou cobertura de regras de validação).
- Rastreabilidade: se o fornecedor entrega um modelo padrão de logs e correlação (por ID de lote, equipamento, versão de cenário, parâmetros e motivos de decisão).
- Estratégia de exceptions: se há uma matriz de exceções (falha de sensor, dados atrasados, comunicação perdida, evento duplicado) com ações definidas e estados resultantes.
- Governança: como será o fluxo de aprovação de mudança, quais controles de versão e quais critérios para rollback.
- Documentação útil: existência de um “manual operacional do cenário” que a operação consegue usar durante incidentes.
- Suporte pós-go-live: prazo de acompanhamento, SLA de correção, e critérios de aceite para encerramento de projeto.
Além disso, o custo não é apenas do desenvolvimento: existe custo de integração com sistemas legados, custo de comissionamento (testes no ambiente real), custo de treinamento, custo de documentação e custo de ciclos de mudança durante a vida útil. Um fornecedor que entrega um “scenario-ready” para manutenção tende a ser mais caro inicialmente, mas frequentemente reduz custo total (TCO) e risco operacional.
Outro ponto é o alinhamento do fornecedor ao seu padrão de arquitetura. Se a sua planta exige integração com MES e ERP, e o fornecedor não tem maturidade em orquestração por eventos ou em modelagem de mensagens idempotentes (tratamento de duplicidade), o custo de correção vira um multiplicador. Assim, o que importa é a compatibilidade entre o modelo do cenário e o ecossistema do cliente.
Quando a proposta comercial é baseada apenas em “homens/hora” e não em entregáveis, existe risco de subinvestimento em testes e evidências. Um cenário operacional que não seja testado com falhas representa risco: o custo aparece depois, em parada, retrabalho e incidentes. Por isso, recomenda-se exigir entregáveis como:
- especificação do cenário (estados, transições, regras, exceções e critérios de sucesso);
- matriz de rastreabilidade (requisito → implementação → teste → evidência);
- casos de teste FAT/SAT com resultados esperados;
- exemplos de logs e mensagens de erro (amostras);
- plano de rollback e critérios de aceite.
Essa disciplina torna a comparação de fornecedores mais justa. O menor preço pode ser apenas menor gasto imediato, não menor risco nem menor custo total. Uma análise madura inclui o custo de “não ter evidência” e o custo de “ter evidência incompleta”.
5) Boas práticas para desenhar cenários robustos
A qualidade de um “Scenario Automação” depende de disciplina de engenharia. Algumas práticas costumam gerar diferença real:
5.1) Defina estados e transições com clareza
Um bom cenário descreve estados (ex.: pronto, aguardando, executando, em exceção, finalizado) e as transições permitidas. Em automação, isso evita loops inesperados e facilita testes.
Estados e transições devem ser definidos de modo que a operação entenda o “onde o processo está”. Um erro comum é criar estados demais sem necessidade (complexidade) ou criar estados genéricos demais (falta de diagnóstico). O ideal é que o estado seja suficientemente granulado para orientar decisão e exceção, mas não tão detalhado que inviabilize manutenção.
Para melhorar robustez, use uma nomenclatura consistente e que traduza significado. Se o cenário “Bloqueado” existir, ele deve carregar um subtipo: bloqueio por qualidade, bloqueio por comunicação, bloqueio por intertravamento, bloqueio por ausência de pré-requisito. Isso permite que o operador saiba qual ação tomar e o engenheiro saiba como testar e corrigir.
Além disso, descreva transições com condições explícitas. Por exemplo: “Aguardando insumo” → “Validar dados” só quando houver evento de chegada e quando o dado estiver dentro de janela temporal. Se a condição não for atendida, a transição não deve ocorrer e o cenário deve permanecer no estado correto, produzindo evidência de bloqueio.
Em sistemas distribuídos, considere também a reentrada (re-entrancy). Um cenário pode receber o mesmo evento repetidamente; portanto, transições devem ser idempotentes: ao receber evento duplicado, o cenário deve reconhecer que já está no caminho correspondente e não repetir ações perigosas. Isso é particularmente importante em integração com mensagens e APIs.
5.2) Trate dados como parte do controle
Condições dependem de dados. Portanto, o cenário precisa prever qualidade de entrada: valores fora de faixa, leituras inconsistentes, atrasos, duplicidade de eventos e falhas de comunicação. A confiabilidade do cenário vem tanto do controle quanto da validação do dado.
Uma boa prática é classificar dados por criticidade e por tipo de falha. Por exemplo:
- Dados de status: exigem consistência e atualização em tempo razoável; atrasos podem exigir caminho de exceção.
- Dados de medição: exigem validação em faixa, tipo de unidade (escala) e coerência com medições correlatas.
- Eventos: exigem idempotência, ordem (quando aplicável) e deduplicação por ID.
- Parâmetros: exigem versionamento, validação de schema e compatibilidade (não basta que “exista”, precisa ser “válido”).
Também é importante explicitar o comportamento quando o dado está ausente. Muitas lógicas assumem que ausência equivale a zero ou equivale a “falha genérica”. Em automação robusta, ausência deve ser tratada como categoria de falha: “dado não recebido”, “dado vencido” (stale data) ou “dado inválido”. Cada categoria pode levar a uma rota diferente de recuperação.
Além disso, valide unidades e escalas. Em integração, é comum receber valores em unidades diferentes (por exemplo, Celsius vs Kelvin, ou pressão em bar vs kPa). Um cenário robusto não permite que esse tipo de erro se torne decisão operacional sem validação.
Outro ponto: dados podem ser “corretos” individualmente, mas incoerentes em conjunto. Por exemplo, uma medição indica temperatura em alta, mas um sensor de vapor sugere ausência de calor. A validação deve contemplar regras de consistência cruzada (quando aplicável), reduzindo falsos positivos e evitando decisões que “fazem sentido” para cada sensor isoladamente.
5.3) Planeje exceções desde o início
Em muitos projetos, exceções entram “quando der”. O custo disso costuma aparecer na fase de comissionamento e nas paradas. Para um cenário coerente, exceções devem ter:
- detecção (como identificar o problema),
- ação (o que fazer),
- resultado esperado (o que muda no estado),
- registro (que evidência produzir).
Uma exceção bem desenhada não é apenas “falhar e parar”. Ela precisa definir um comportamento seguro e recuperável. Em automação, isso geralmente envolve: parar etapas críticas, manter o processo em estado estável, sinalizar necessidade de intervenção (quando aplicável) e impedir que ações perigosas se repitam.
Exceções também precisam de critérios de escalonamento. Por exemplo:
- Exceção leve: pode tentar recuperação automática (reler sensor, repetir comunicação, solicitar novo evento) dentro de uma quantidade limitada e com backoff.
- Exceção moderada: bloqueia passo, exige confirmação do operador ou intervenção parcial.
- Exceção crítica: aciona modo seguro, registra evidência e exige ação humana qualificada.
Uma armadilha frequente é criar “recuperações” automáticas que escondem problemas de causa raiz. Por exemplo, ao falhar validação de qualidade, o cenário pode repetir leitura até obter valor “dentro da faixa”, mas isso pode mascarar um sensor degradado. Em cenários robustos, a repetição deve ser limitada e acompanhada de evidência (por exemplo, contador de tentativas e razão da exceção). Se exceder o limite, a rota deve mudar para bloqueio e manutenção.
Além disso, exceções devem ser testadas. Testar apenas o caminho feliz gera falsa confiança. O fornecedor ou time que não entrega testes de falha (com comunicação instável, sensores fora de padrão, eventos duplicados) tende a atrasar ou gerar retrabalho na fase de comissionamento.
5.4) Construa rastreabilidade e documentação úteis
Rastreabilidade significa conseguir responder: por que o cenário tomou uma decisão em um momento específico. Logs e correlações (timestamp, correlação de eventos, versão do cenário e parâmetros) são fundamentais.
Uma rastreabilidade útil deve ter pelo menos quatro camadas:
- Identidade do contexto: qual equipamento, qual produto/lote, qual ciclo, qual instância do cenário.
- Identidade da lógica: qual versão do cenário, qual modelo executável, quais parâmetros aplicados.
- Identidade das entradas: quais eventos e quais dados foram usados na decisão (com qualidade/validade).
- Identidade das saídas: qual ação foi executada, qual estado resultante, quais sinais foram enviados.
Além disso, a documentação deve ser orientada para uso real. Uma documentação que apenas descreve arquitetura, mas não explica o comportamento sob falhas, não é suficiente. A operação precisa de mensagens e guias práticos: “Se a falha X ocorrer, verifique Y, execute Z”. A engenharia precisa de detalhes para corrigir: “Falha ocorreu em condição de stale data; janela de validade configurada em A; sensor Z com deriva identificada”.
Outro aspecto de rastreabilidade é a compatibilidade com auditoria. Se a planta exige conformidade, você precisa garantir que logs não sejam apenas técnicos (readout bruto), mas que também indiquem conformidade com regras. Por exemplo: registro de aprovação de etapa com identificação da condição que permitiu a transição, e registro de bloqueio com motivo.
Rastreabilidade também reduz custo de “pós-incidente”. Quando um problema acontece, o time precisa rapidamente reconstruir sequência de eventos. Sem correlação, a investigação vira busca manual de telas, tickets e prints, aumentando tempo de parada.
5.5) Teste como rotina, não como formalidade
Um cenário deve ser validado com testes que cubram o “caminho feliz” e também o caminho de falhas (comunicação, intertravamento, sensores fora do padrão, dados incompletos). A cultura de testes é o que separa automação “demonstrável” de automação “operável”.
Boas práticas de teste para cenários incluem:
- Testes de unidade para regras: validar validações de faixa, consistência e schema de dados.
- Testes de integração para eventos: validar ordem, duplicidade, latência e idempotência.
- Testes de estado: validar transições permitidas e proibidas e comportamento em cada estado.
- Testes de regressão: garantir que mudanças em regras não quebram exceções existentes.
- Testes de observabilidade: verificar se logs possuem campos obrigatórios e se correlação funciona.
Também é crucial testar “tempo” como parte do comportamento. Em automação, janelas temporais podem ser a diferença entre operar bem e parar. Teste condições como: dado chega atrasado, evento chega duplicado, comunicação oscila e volta.
Por fim, defina critérios objetivos de sucesso de teste. Em vez de “funciona no teste”, use métricas: “estado final atingido em X minutos”, “taxa de retries não excede N”, “erro classificado como categoria correta”, “log contém motivo e evidência do dado”. Critérios objetivos reduzem subjetividade e aceleram aceites.
6) Comparação prática: cenários, regras e condições (tabela de apoio)
| Elemento | O que é | Como isso aparece no “Scenario Automação” | Falha típica quando não é tratado |
|---|---|---|---|
| Cenário | Fluxo executável com etapas e decisões | Orquestra passos, gatilhos, estados e exceções | Comportamento inconsistente entre turnos e versões |
| Regra | Condição lógica aplicada a decisões | Define quando um passo pode prosseguir | Processo continua com dados inválidos |
| Condição | Critério verificável em tempo de execução | Faixas, pré-requisitos, disponibilidade e qualidade | Intertravamentos não se aplicam no momento certo |
| Exceção | Tratamento de falha ou desvio | Define ação segura, retorno e evidência | Operador precisa “adivinhar” a causa e a resposta |
| Rastreabilidade | Capacidade de explicar decisões | Logs, correlação de eventos e versão do cenário | Dificuldade em auditoria e correção rápida |
7) Guia passo a passo para implementar “Scenario Automação” com qualidade
A seguir, um roteiro prático (com foco em engenharia e operação). Ajuste de acordo com o seu contexto industrial e o seu ecossistema de automação (CLP/SCADA/MES/ERP, redes e padrões internos).
7.1) Levantamento e definição do escopo
- Identifique o processo alvo e o objetivo do cenário (reduzir variação, melhorar tempo de ciclo, padronizar etapas, diminuir paradas).
- Liste sistemas e equipamentos envolvidos (incluindo fontes de dados).
- Defina o nível de granularidade: do “macro flux” às decisões em microestados.
- Defina o que está fora do escopo (evita expectativas divergentes e lógica mal encaixada).
Nesta etapa, é útil criar uma “fronteira” clara: o que o cenário controla diretamente e o que apenas monitora. Por exemplo, em muitos ambientes, o intertravamento físico (para segurança) é responsabilidade do CLP/SIS, enquanto o cenário pode orquestrar sequenciamento e integração com MES. Se essa fronteira não fica clara, o projeto pode terminar com lógica duplicada ou com responsabilidades mal distribuídas entre camadas.
Também vale levantar os “pontos de verdade” (source of truth). Em geral, status de equipamento e dados de qualidade podem estar em múltiplos lugares (tags locais, banco do MES, sistema SCADA). O cenário precisa saber qual fonte é autoritativa em cada tipo de dado e qual política de sincronização usar. Quando isso não é definido, o cenário pode operar com inconsistências.
7.2) Mapeamento de eventos e dados
- Defina gatilhos (evento de processo, leitura de sensor, sinal de equipamento, confirmação em sistema).
- Defina quais campos são críticos e como validar qualidade e consistência.
- Estabeleça regras para lidar com atraso, duplicidade e perda de comunicação.
- Defina janelas de validade e o comportamento quando o dado estiver “stale”.
Ao mapear eventos, pense em idempotência: todo evento recebido deve ter uma chave de deduplicação (por exemplo, ID de lote + etapa + timestamp lógico) ou um mecanismo equivalente. Sem isso, eventos duplicados podem levar a repetição de ações (como reclassificar um lote, reemitir um comando ou registrar duas vezes no sistema corporativo).
Além disso, padronize semântica de eventos: “sensor_abertura” pode significar “alcançou valor acima do limiar” ou “transição detectada”. Se semânticas diferentes forem usadas inadvertidamente, o cenário pode entrar em estados incorretos. Documente e valide semânticas com operação e engenharia.
Outro ponto é o mapeamento de qualidade do dado. Em instrumentação e redes industriais, dados podem ter qualidade degradada: confiabilidade, saturação, falta de calibração, ou falhas intermitentes. O cenário deve carregar metadados de qualidade e usar isso explicitamente nas regras.
7.3) Desenho lógico: estados, transições e intertravamentos
- Modele estados do processo e transições permitidas.
- Defina critérios de sucesso e condições de bloqueio (incluindo “o que não fazer”).
- Inclua tratamento de falha e estratégia de retorno a modo seguro.
- Crie uma matriz de intertravamentos (o que impede avanço, o que permite rollback e em quais condições).
Nesta etapa, o desenho deve refletir o comportamento esperado tanto em situações normais quanto em situações degradadas. Um cenário robusto define “o que não fazer” tão claramente quanto define “o que fazer”. Por exemplo: não avançar etapa crítica se a qualidade de sensor estiver abaixo de um limiar; não registrar aprovação se o sistema corporativo estiver indisponível; não executar comando de etapa se o status do equipamento não estiver coerente.
Ao tratar retorno a modo seguro, defina: (1) o estado seguro (o que acontece fisicamente e logicamente), (2) a ação de parada ou de manutenção (por exemplo, manter em hold, desligar aquecimento, manter válvula na posição padrão), (3) a sinalização para operação (alarme com categoria), (4) a evidência (logs e contadores).
Também considere transições de “recuperação”. Em alguns cenários, a recuperação pode reexecutar validações e retentar integração; em outros, precisa pedir intervenção manual. O desenho deve refletir o risco associado.
7.4) Implementação em camadas (quando aplicável)
- Separe responsabilidades (por exemplo: controle básico em camada de automação; orquestração e integração em camadas superiores).
- Padronize blocos e bibliotecas reutilizáveis.
- Garanta consistência de nomenclatura, versões e parâmetros de cenário.
- Defina interfaces claras entre camadas (contratos de eventos e comandos).
Em arquitetura em camadas, uma regra importante é minimizar acoplamento. O cenário deve chamar “serviços” internos que executam ações específicas (por exemplo, enviar comando ao equipamento, solicitar leitura do sensor, registrar evento no MES). Dessa forma, a lógica do cenário permanece estável enquanto a implementação de serviços pode evoluir sem reescrever tudo.
Também é recomendável que a camada de integração seja idempotente. Se um serviço envia um registro ao MES, ele deve evitar duplicidade: por exemplo, usando chaves idempotentes, ou registrando “já enviado” e revalidando antes de reenviar. Isso reduz risco quando há reprocessamento por falhas de rede.
Outra prática é criar um mecanismo padrão de “contexto do cenário” (por exemplo, um objeto/estrutura com IDs e parâmetros). Assim, logs, mensagens e decisões usam a mesma base de correlação, facilitando rastreamento e depuração.
7.5) Plano de testes FAT/SAT e validações operacionais
- Prepare casos de teste para o caminho feliz e caminhos de falha.
- Valide comportamento sob cenários de dados incompletos e comunicação instável.
- Simule falhas relevantes e verifique se o cenário registra evidências e executa a ação prevista.
- Inclua testes de temporização e janelas de validade (dados atrasados, sensores “stale”).
Além de testar o que acontece, verifique também o que é observado. Por exemplo: quando o cenário bloqueia por falha de validação, o log deve indicar qual regra falhou e quais dados estavam fora do padrão. Se o cenário executa uma recuperação automática, ele deve registrar contadores e ações realizadas.
Uma prática útil é criar uma “matriz requisito → teste → evidência”. Assim, cada requisito de segurança, qualidade de dados, rastreabilidade e comportamento em exceções tem uma verificação associada. Essa matriz também ajuda na governança e na auditoria, porque demonstra que não houve “lacuna” de teste.
Em SAT (teste no local), considere variabilidade do ambiente: ruído elétrico, variação de comunicação, diferenças de latência entre máquinas. Muitas falhas só aparecem em campo; por isso, cenários de falha precisam estar realistas.
7.6) Governança de mudança e treinamento
- Defina procedimento de mudança (versões do cenário, approvals e janela de implantação).
- Treine operação: como monitorar, como reconhecer exceções e como atuar conforme o cenário.
- Estabeleça política de retrocesso (rollback) e critérios de aceite para liberar em produção.
- Crie um canal de comunicação para incidentes pós-implantação (quem responde, como registrar, como classificar).
Governança não deve ser burocrática; deve ser eficaz. Um mecanismo típico é: (1) congelar requisitos e critérios, (2) implementar mudança com versionamento, (3) rodar testes definidos (mínimo e regressão), (4) aprovar e implantar em janela planejada, (5) monitorar e coletar evidência, (6) fechar com relatório e lições aprendidas.
O treinamento precisa ser orientado a situações reais. Em vez de apenas ensinar “o que é o cenário”, ensine o operador a reconhecer estados e mensagens e a executar ações prescritas. Isso reduz improviso e reduz variação entre turnos.
Uma parte essencial do treinamento é explicar a diferença entre falhas de dados, falhas de comunicação e falhas de intertravamento. O operador não deve tratar tudo como “problema no equipamento”; o cenário deve indicar a categoria com clareza.
O rollback deve ser praticável. Muitas vezes, o rollback é “teórico”. Em um incidente, se não houver como retornar rapidamente para uma versão estável, o custo de parada aumenta. Por isso, defina critérios objetivos para rollback (por exemplo, aumento repentino de taxa de exceção, comportamento divergente de estado, falha de integração com MES).
7.7) Operação assistida e melhoria contínua
- Monitore métricas relevantes (qualidade, taxa de exceção, tempo de recuperação, consistência de dados).
- Revisite o cenário com base em logs e lições aprendidas.
- Atualize regras e exceções para refletir evolução do processo e da instrumentação.
- Faça revisões periódicas de “edge cases” mais frequentes.
Operação assistida significa que o cenário ajuda a operação a entender e resolver. Isso pode incluir: dashboards com estados, alertas com categoria e instruções, e relatórios pós-lote indicando motivo de bloqueios ou recuperações.
A melhoria contínua deve ser baseada em evidência. Em vez de “melhorar porque sim”, use logs e métricas: quais exceções ocorreram mais, em quais equipamentos, em quais produtos, em quais turnos, com quais versões. Isso orienta mudanças com menor risco.
Também é recomendado implementar “mecanismos de feedback” para identificar quando dados mudaram. Por exemplo, se um sensor foi calibrado ou se um equipamento passou a operar com novo comportamento, o cenário pode precisar de ajuste de validações e janelas de qualidade. Sem mecanismo de feedback, a automação entra em “desvio silencioso”.
8) Fontes e base técnica (para sustentar decisões)
Para apoiar práticas de engenharia e governança em automação, recomenda-se alinhar o desenho e os testes com referências reconhecidas. Como base documental e metodológica, consulte:
- IEC 61508 e IEC 61511: fundamentos de segurança funcional e abordagem sistemática para reduzir riscos em sistemas instrumentados de segurança (SIS).
- NIST (recomendações e publicações sobre segurança em sistemas industriais/OT): boas práticas para gestão de riscos, integridade e controles.
- Normas de segurança cibernética e diretrizes industriais (quando aplicáveis ao seu ecossistema).
Essas referências ajudam a estruturar condições/arquitetura e a justificar decisões de confiabilidade e segurança sem depender de estimativas especulativas. Quando o seu projeto envolver requisitos regulatórios específicos, trate as exigências locais com o responsável de conformidade.
Embora o tema central deste artigo seja o desenho lógico de cenários (gatilhos, estados, regras, exceções e rastreabilidade), é importante mencionar que decisões de arquitetura e segurança funcional frequentemente devem ser consistentes com normas. Por exemplo, em sistemas com SIS, a lógica de segurança precisa seguir métodos de desenvolvimento, validação e verificação compatíveis com as normas relevantes. O cenário pode ser parte do desenho global do processo, mas não deve violar premissas de segurança funcional.
Além disso, a segurança cibernética influencia a robustez do cenário. Se um cenário depende de eventos via rede, uma falha de integridade de dados, um ataque ou um erro de configuração de segurança pode introduzir eventos maliciosos ou dados falsos. Por isso, vale alinhar validação e autenticação/autorização com o padrão de segurança do ambiente. Em cenários robustos, validação de schema e integridade de mensagem é uma camada essencial.
Também é útil referenciar práticas de engenharia de sistemas, como gestão de requisitos, rastreabilidade de mudanças e testes automatizados. Mesmo quando normas regulatórias não impõem diretamente uma metodologia específica para o “cenário”, elas geralmente reforçam a importância de demonstrar que o sistema se comporta como especificado e que falhas são tratadas adequadamente.
9) Condições e requisitos para considerar um “Scenario Automação” pronto para produção
- Critérios de aceite definidos: o que comprova que o cenário funciona corretamente (inclusive em falhas).
- Rastreabilidade implementada: logs, correlação de eventos e indicação de versão do cenário.
- Tratamento de exceções validado: ação de retorno seguro e resposta operacional prevista.
- Validação de dados: checagem de qualidade, faixa e consistência antes de decisões críticas.
- Governança de mudança: procedimento de atualização e mecanismo de retrocesso.
- Treinamento e comunicação: operação entende o que pode ocorrer e como reagir.
Se qualquer requisito ficar como “implícito” ou “presumido”, o cenário tende a degradar na manutenção. Em operação, a clareza salva tempo, reduz paradas e protege pessoas e ativos.
Para aprofundar, considere também critérios adicionais que frequentemente diferenciam cenários realmente “operáveis” de cenários apenas “deployados”:
- Disponibilidade e tolerância a falhas: o cenário lida com indisponibilidade temporária de integração (por exemplo, MES/ERP) sem gerar estados inconsistentes? Existe política de reprocessamento?
- Consistência transacional: quando o cenário registra eventos em sistemas externos, existe garantia de consistência (evitar “meio caminho” entre sistemas)?
- Resiliência a duplicidade: reenvios e reprocessos não geram efeitos duplicados.
- Observabilidade: dashboards e alertas refletem estados e categorias de falha com precisão.
- Capacidade de diagnóstico: em incidentes, o time consegue reconstruir sequência com evidências suficientes.
Outro critério crítico é “compatibilidade de versões”. Se a planta evolui e sistemas externos mudam de schema ou semântica, o cenário precisa lidar com isso. Mesmo que o cenário seja parametrizável, a validação de schema e a estratégia de fallback (quando um campo novo/antigo aparece) evitam que a automação “quebre” silenciosamente.
Além disso, “pronto para produção” implica que as rotinas de manutenção estão definidas. Se um sensor falha repetidamente e o cenário muda para modo seguro, a equipe precisa saber como verificar calibração, substituir instrumentação ou ajustar janelas. O cenário deve se conectar ao processo de manutenção (por exemplo, emitindo alertas com código de falha e orientação de causa provável).
10) Perguntas frequentes (FAQs) sobre “Scenario Automação”
10.1) “Scenario Automação” é o mesmo que automação de processos?
Não necessariamente. Automação de processos é um objetivo amplo (automatizar etapas do processo). “Scenario Automação” é uma forma de organizar e executar logicamente decisões e fluxos com gatilhos, estados e exceções. Em muitos projetos, o cenário passa a ser o “modelo” que materializa a automação do processo.
Uma forma útil de diferenciar é pensar que automação de processos responde “o que fazer para produzir” enquanto cenário responde “como decidir e como agir sob variabilidade e falhas”. O cenário organiza a tomada de decisão e a ação sob condições reais.
10.2) Como lidar com requisitos que mudam durante o projeto?
Use governança de mudança: versionamento do cenário, validação de impacto e reexecução de testes relevantes. O risco não é apenas “o que muda”, mas se as exceções e critérios de sucesso continuam consistentes com a nova realidade operacional.
Na prática, isso significa que mudanças de requisitos precisam ser acompanhadas de atualização de: regras, matrizes de exceções, critérios de bloqueio e rotas de recuperação. Além disso, deve haver revisão da documentação operacional e do treinamento. Mudanças que impactam mensagens e categorias de falha precisam ser comunicadas à operação.
10.3) Quais dados são mais críticos para a confiabilidade do cenário?
Em geral, dados com impacto direto em condições de segurança e continuidade (status de equipamento, qualidade de sensor, sinais de disponibilidade e eventos de processo). A regra de ouro é validar dados antes de tomar decisões automatizadas.
Como refinamento, dados críticos variam por etapa: em etapas de preparação, dados de disponibilidade e status são críticos; em etapas de validação de qualidade, as medições e sua qualidade são críticos; em etapas de integração com sistemas corporativos, dados de identificadores (lote, produto, receita) e consistência de schema são críticos.
10.4) Como justificar custo de implantação sem depender apenas de “preço por hora”?
Compare escopo e evidências: plano de testes, rastreabilidade, documentação, estratégia de exceções e suporte pós-go-live. Um fornecedor que entrega melhores mecanismos de evidência reduz custo indireto (retrabalho, paradas e esforço de correção).
Outra forma de justificar custo é apresentar uma matriz de risco: quais riscos operacionais são mitigados por um cenário robusto? Se a automação reduz a chance de decisões erradas sob falha de dados, isso reduz probabilidade de incidente e tempo de recuperação. Em muitos cenários, o custo de parada e o custo de retrabalho excedem o diferencial de custo do projeto.
10.5) O que acontece quando o cenário “funciona” no teste, mas falha na operação?
Geralmente é um problema de lacunas de exceção, dados não previstos, diferenças de ambiente (latência de rede, variações de sensores) ou falta de critérios claros de aceite. Por isso, testes devem cobrir caminhos de falha e validação de qualidade de dados.
Para evitar isso, use dados reais (quando possível) em simulações, ou simule condições próximas do ambiente de produção. Além disso, considere testes com “ruído” e variações (por exemplo, atrasos e duplicidade). Falhas em operação costumam ocorrer exatamente nesses cenários de borda.
10.6) É possível reutilizar cenários em plantas diferentes?
Sim, desde que você separe o que é “genérico” (padrões de estados, tratamento de exceções e modelo de rastreabilidade) do que é “específico” (parâmetros, endereços de I/O, regras do processo e integrações). A reutilização depende de uma estratégia de parametrização e padronização.
O caminho típico é criar uma biblioteca de componentes: regras comuns, classes de validação, templates de exceções e mecanismos de logs. A reutilização reduz custo e aumenta consistência, mas precisa ser controlada por testes de adaptação (a planta nova pode ter instrumentação e semântica diferentes).
10.7) Qual o papel do operador em um cenário bem projetado?
Mesmo em automação avançada, o operador é parte do sistema de decisão em exceções. O cenário deve indicar o que fazer, como reconhecer o estado e quais evidências verificar. Isso melhora a segurança e reduz o tempo de recuperação.
Em cenários bem projetados, a operação não precisa “compreender todo o software”; ela precisa compreender o significado do estado e as ações recomendadas. Mensagens de erro com categoria e instruções claras aumentam eficiência e reduzem risco de ação incorreta.
11) Conclusão: “Scenario Automação” como alicerce de confiabilidade e evolução
“Scenario Automação” é mais do que um desenho de fluxo: é uma disciplina de engenharia que organiza gatilhos, estados e exceções de forma rastreável e testável. Quando aplicada com governança, validação de dados e planejamento de falhas, a automação deixa de ser frágil e passa a ser operável, auditável e evolutiva. Para projetos que envolvem múltiplas frentes — processo, engenharia, TI/OT e operação — esse modelo é frequentemente o fator que transforma complexidade em previsibilidade.
Ao tratar o cenário como contrato técnico-operacional e artefato de evidência, você reduz ambiguidades, diminui variação entre turnos e versões e melhora o tempo de diagnóstico em incidentes. Ao planejar exceções e rastreabilidade desde o início, o sistema consegue lidar com o que inevitavelmente acontece em plantas reais: dados imperfeitos, comunicações instáveis, eventos duplicados e mudanças de requisitos.
Se você quiser, posso adaptar o texto para um setor específico (ex.: logística, energia, manufatura discreta ou contínua) e elaborar um exemplo de cenário com estados, gatilhos e exceções (mantendo a mesma abordagem objetiva e orientada a requisitos).
-
1

Maintaining Oral Health with Dental Implants for the Elderly
-
2
Leasing a Car: Expert Tips for Your Next Vehicle
-
3
Maintaining Oral Health After Tooth Loss with Dental Implants
-
4
Guide to Senior Living Apartments: Affordable and Comfortable Environments
-
5
Affordable Independent Living: Finding the Right Senior Housing